Что люди реально сохраняют: data-исследование (2026)
Что люди реально сохраняют: 558 видео, 622 сохранёнки и 358 поисков на SavedThat. Коротких видео больше, но 90% слов приходится на YouTube.
Почти всё, что пишут про то, что люди реально сохраняют, - это ощущения. А это запрос к базе. В мае 2026 мы опубликовали первый срез на 119 видео; здесь тот же запрос, выполненный 21 сентября 2026 на корпусе в 4,7 раза больше, и главный вывод перевернулся.
Четыре находки, по возрастанию неожиданности:
- Микс платформ перевернулся. В мае две трети сохранений были с YouTube. Сегодня 76% сохранений - короткие видео, а YouTube - 24%.
- На объём работы это не повлияло. YouTube всё ещё даёт 90% текста транскриптов и 82 часа из 89. Люди сохраняют много коротких видео и несколько очень длинных.
- Доля пустых поисков упала вдвое, с 16% в мае до 8% за последние 90 дней, причём ранжирование мы не трогали. Корпус дорос до запросов.
- Примерно каждое восьмое сохранение - дубль видео, которое кто-то уже сохранил. Это строка расходов, а не метрика для красоты.
Датасет: на чём считалось
- Видео в выборке: 558 со статусом
ready, без тейкдаунов, на 21 сентября 2026. Ещё три лежат вfailedи исключены. - Сохранёнки: 622 против 539 уникальных единиц контента (одно видео могут сохранить несколько человек, транскрипт хранится один раз).
- Зарегистрированных юзеров: 121, из них 52 сохранили хотя бы одно видео.
- Поисков залогировано: 358 за всё время от 31 юзера; 119 из них за последние 90 дней от 17 юзеров.
- Чанков в индексе: 24 899, из них 20 703 из речи, остальные из визуального разбора.
439 из 558 видео появились уже после майского среза. Именно поэтому этот пересчёт стоит публиковать: четыре пятых данных - новые.
Одна оговорка, которую держим на виду. Продукт молодой и B2C, аудитория самоотобранная. Паттерны на 558 видео интересны как направление, но статистически тонкие, и микс платформ в первую очередь описывает тех, кто зарегистрировался в этом квартале.
Микс платформ: коротких больше, но контент в YouTube
| Платформа | Сохранено видео | % сохранений | Медианная длина |
|---|---|---|---|
| Instagram Reels | 349 | 62,5% | 0:46 |
| YouTube | 133 | 23,8% | 21:28 |
| TikTok | 61 | 10,9% | 1:26 |
| YouTube Shorts | 15 | 2,7% | 0:52 |
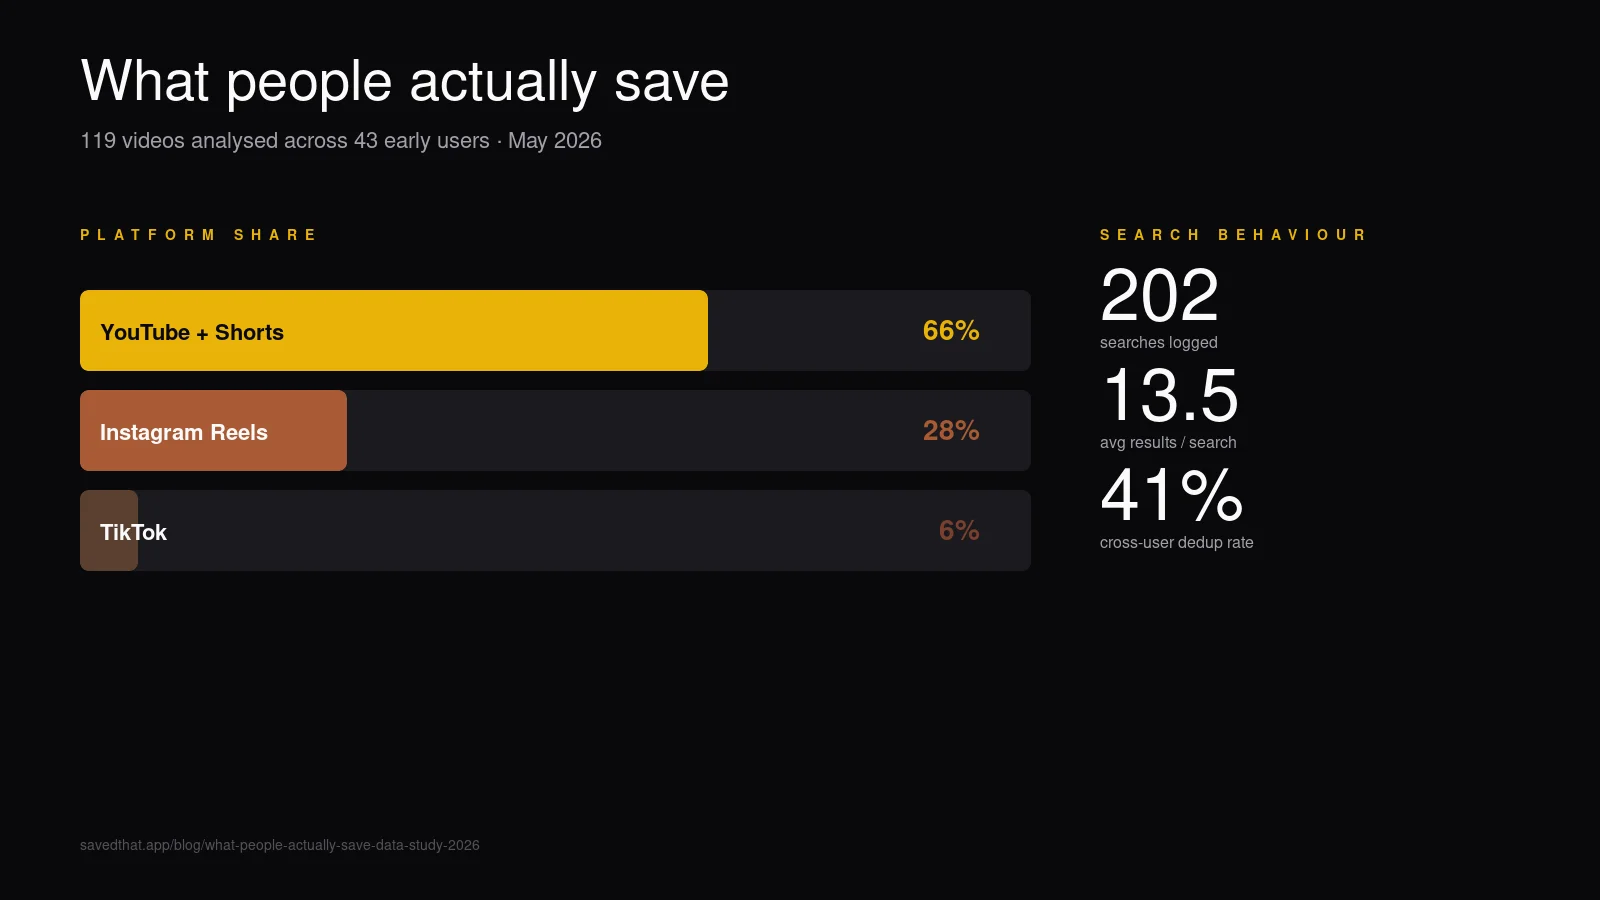
В мае та же таблица показывала 66% YouTube и 28% Instagram. Разворот реальный, и у него есть точный момент. По месяцам: в апреле и мае на каждый Reels приходилось примерно два видео с YouTube; с июня Instagram обгоняет YouTube каждый месяц без исключений, а пик был в июне - 87 Reels против 4 видео с YouTube. Это факт про тех, кто пришёл летом, а не про видео вообще. Медианы считались по 539 видео, у которых есть длительность; у 19 видео, в основном из Instagram, её нет.
Медианы стоит запомнить. Сохранённый Reels - 46 секунд. Сохранённый TikTok - 86 секунд. Сохранённое видео с YouTube - 21 минута 28 секунд, а среднее 39 минут, потому что хвост двухчасовых подкастов тянет его вверх.
Соотношение, которое решает всё в инженерии
Счётчики обманывают, поэтому считаем текст. Сумма символов по всем речевым чанкам корпуса:
| Платформа | Символов транскрипта | % произнесённого | Часов видео |
|---|---|---|---|
| YouTube | 4 766 365 | 90,2% | 82,2 |
| Instagram Reels | 385 872 | 7,3% | 5,1 |
| TikTok | 118 960 | 2,3% | 1,7 |
| YouTube Shorts | 12 297 | 0,2% | 0,2 |
Одна платформа держит четверть сохранений и девять десятых слов. Из-за этого разрыва вопрос «что люди реально сохраняют» сам по себе вводит в заблуждение: по количеству это продукт про короткие видео, по содержанию - про длинные, и два ответа требуют совершенно разных индексов. Попадание в поиске гораздо чаще окажется в YouTube-видео, чем следует из доли сохранений, просто потому что предложения лежат там.
Длительность: сохранений мало длинных, а минут мало коротких
| Диапазон | Видео | % от всех |
|---|---|---|
| Меньше минуты | 259 | 48% |
| От 1 до 10 минут | 185 | 34% |
| От 10 до 30 минут | 49 | 9% |
| От 30 до 60 минут | 22 | 4% |
| Больше часа | 24 | 4% |
Двугорбое распределение, про которое мы писали в мае, никуда не делось, но левый горб съел почти всё: почти половина сохранённого короче минуты. Диапазон от 1 до 10 минут, который мы в мае назвали ничейной серединой, вырос с 24% до 34% и стал вторым по размеру.
Под эту середину до сих пор никто не строит. «Смотреть позже» на YouTube обращается с восьмиминутным разбором как с полуторачасовой лекцией, а инструменты для хайлайтов - как с тридцатисекундным клипом. Ни то ни другое не совпадает с тем, как этим пользуются. Если таких видео у тебя много, сделать сохранённые видео с YouTube искомыми - единственный путь, который масштабируется: восьмиминутное видео никто не пересматривает ради одной фразы.
Как ищут в своих сохранёнках: пять слов, и 8% не находят ничего
За последние 90 дней 17 человек сделали 119 поисков. Форма запросов:
- Медиана - 5 слов. Среднее 5,4, самый длинный запрос - 25 слов.
- 66% запросов длиной от четырёх слов. Люди набирают фразу, которую наполовину помнят, а не ключевое слово.
- 19% запросов - одно слово, обычно тема, а не цитата.
- Среднее число результатов: 10,2.
- Пустых поисков: 9 из 119, то есть 8%. За всё время - 13%.
Падение доли пустых поисков вдвое с мая - цифра, которую мы будем защищать упорнее всего, потому что ранжирование ради неё не трогали. Запрос не находит ничего по трём причинам: видео не сохраняли, транскрипт бедный, или язык запроса слишком далеко от языка транскрипта. Первая причина уходит сама по мере наполнения библиотеки, и здесь произошло в основном это.
Медиана в пять слов - несущий факт для всех, кто строит в этой категории. Пятисловные пересказы - ровно те запросы, которые не вытягивает индекс по ключевым словам, поэтому поиск у нас гибридный, а не только по словам: человек, который помнит «там про то, когда солить воду для пасты», не угадает заголовок автора.
Видео, в которых нечего расшифровывать
Не всё сохранённое содержит речь. По корпусу 30 видео из 558, то есть 5,4%, вернулись без пригодной речи: молчаливые нарезки рецептов, листиклы текстом на экране, чистая музыка.
| Платформа | Готовых видео | Без пригодной речи | Доля |
|---|---|---|---|
| TikTok | 61 | 6 | 9,8% |
| Instagram Reels | 349 | 23 | 6,6% |
| YouTube Shorts | 15 | 1 | 6,7% |
| YouTube | 133 | 0 | 0% |
Ноль на длинном YouTube и каждое десятое на TikTok. Это честный предел поиска по транскриптам, и поэтому в индексе вообще есть визуальный разбор: 4 196 чанков корпуса описывают то, что на экране, а не то, что сказали. Если ищешь молчаливый Reels, транскрипт не спасёт, и любой инструмент, который обещает обратное, описывает демо, а не библиотеку.
Кросс-юзерная дедупликация: каждое восьмое сохранение - дубль
622 сохранёнки указывают на 539 уникальных видео. Это 83 сохранения, 13% от всех, где транскрипт и эмбеддинги уже существовали, потому что то же видео сохранил кто-то другой. У самого популярного видео 21 сохранение. Среднее число сохранений на единицу контента - 1,15.
Число маленькое, эффект - нет. Дубль не стоит ничего: не нужен запрос транскрипта у Supadata, не тратятся эмбеддинги OpenAI, и видео появляется в новой библиотеке примерно за секунду вместо минуты. В мае мы предсказывали, что на масштабе доля вырастет к 70%. Спустя четыре месяца она почти не сдвинулась, и причина видна в таблице платформ: короткие сохранения - это длинный хвост. Двое редко сохраняют один и тот же Reels. Дедупликация концентрируется на популярных видео с YouTube, то есть будет расти вместе с долей длинного контента, а не с числом юзеров.
Публично ошибиться в прогнозе - ровно то, ради чего публикуют методику.
Что изменилось с мая и что это значит
Вопрос категории не «длинное или короткое», а «и то и другое сразу». Инструмент, который индексирует только Reels, будет хорош по количеству и бесполезен на тех 90% контента, где лежат настоящие предложения. Инструмент только под YouTube теряет половину сохранений. Этот аргумент мы приводили в сравнении AI-менеджеров видео-закладок, и корпус с тех пор сказал его громче.
Библиотеки с ростом становятся искомее, а не наоборот. Доля пустых поисков упала, пока корпус вырос вчетверо. Качество поиска в этой категории - сначала задача про корпус и только потом про модель.
Короткие сохранения - личный архив, а не общий. Ровная доля дублей говорит, что средний сохранённый Reels никто другой не сохранял. Такой профиль расходов полезно знать до того, как начинать строить.
Что пересчитаем дальше
Тот же запрос и тот же формат таблицы на 1 000 и на 10 000 видео, чтобы цифры чисто сравнивались с этим срезом и с майским. Следим за тремя вещами: продолжит ли расти доля коротких видео или откатится, продолжит ли падать доля пустых поисков по мере наполнения библиотек, и останется ли доля дублей ровной теперь, когда у нас есть причина этого ожидать.
SavedThat бесплатен, пока идёт бета: 100 сохранений в месяц, 2 часа на видео, 30 часов библиотеки. Хочешь попасть в следующий срез - начни сохранять, и тебя посчитают.
Сырые цифры
Всё выше выводится из этой таблицы. Публикуем её, чтобы любое утверждение можно было проверить.
| Метрика | Значение |
|---|---|
| Видео со статусом ready | 558 |
| Видео в статусе failed (исключены) | 3 |
| Всего сохранёнок | 622 |
| Уникальных единиц контента | 539 |
| Зарегистрированных юзеров | 121 |
| Юзеров хотя бы с одним сохранением | 52 |
| Поисков за всё время | 358 |
| Поисков за последние 90 дней | 119 |
| Юзеров, которые искали хотя бы раз | 31 |
| Медианная длина запроса | 5 слов |
| Запросов от четырёх слов | 66% |
| Пустых поисков за 90 дней | 9 из 119 (8%) |
| Среднее число результатов | 10,2 |
| Instagram Reels (ready) | 349 |
| YouTube (ready) | 133 |
| TikTok (ready) | 61 |
| YouTube Shorts (ready) | 15 |
| Медиана длины: Reels / TikTok / YouTube | 46с / 86с / 21:28 |
| Часов видео в индексе | 89,2 |
| Символов транскриптов в индексе | 5 283 494 |
| Чанков в индексе (речь / визуал) | 20 703 / 4 196 |
| Видео без пригодной речи | 30 (5,4%) |
| Самое сохраняемое видео | 21 юзер |
| Среднее сохранений на единицу контента | 1,15 |
| Дублей сохранений (дедупликация) | 83 (13%) |
Срез снят 21 сентября 2026. Предыдущий срез: 11 мая 2026, 119 видео.
Keep reading
Search inside saved videos: the complete 2026 guide
Search inside saved videos by what was actually said — across YouTube, Instagram, and TikTok. How transcript search works in 2026, and four tools that do it.
Best apps to search saved Instagram Reels (2026)
Best apps to search saved Instagram Reels in 2026, compared honestly: SavedThat, ReelRecall, Quiki, BetterSave, Stasht, Dewey, Collections and DIY.
Best video bookmark manager with transcript search (2026)
The best video bookmark manager with transcript search in 2026: seven tools compared honestly, from SavedThat and Quiki to Raindrop Pro, Mymind and Glasp.
Frequently asked questions (2026)
Что люди сохраняют чаще всего: YouTube, Instagram или TikTok?
По количеству - Instagram Reels: 349 видео из 558 в этом корпусе, то есть 62,5%, против 23,8% у YouTube и 10,9% у TikTok. По содержанию - YouTube: на него приходится 90,2% символов транскриптов и 82 часа из 89. Какая платформа «побеждает», полностью зависит от того, считаешь ты видео или минуты.
558 видео - достаточная выборка для выводов?
Достаточная, чтобы описать этот корпус, и не более. Аудитория самоотобранная и небольшая, поэтому микс платформ стоит читать как факт про юзеров SavedThat в 2026 году, а не про сохранение видео вообще. Методика и точные числа опубликованы, чтобы следующий срез на 1 000 видео можно было сравнить напрямую.
Почему микс платформ перевернулся с мая?
Дело в аудитории, а не в поведении. 439 из 558 видео появились после мая, и пришедшие в этот период юзеры сохраняют короткие видео. По месяцам переключение резкое: в апреле и мае вёл YouTube, с июня каждый месяц ведёт Instagram, а TikTok стал заметной долей только с августа.
Какой длины типичный запрос в библиотеке сохранённых видео?
Медиана - пять слов за последние 90 дней, среднее 5,4, и 66% запросов длиной от четырёх слов. Это территория пересказа, а не ключевых слов, поэтому обычный индекс по ключевым словам на такой библиотеке обычно не работает.
Сколько сохранённых видео остаются без пригодного транскрипта?
30 из 558, то есть 5,4%. На TikTok это 9,8%, на Instagram Reels 6,6%, на длинном YouTube - ноль. Обычные случаи: молчаливые нарезки, посты с текстом на экране и клипы под музыку. Находить их помогает визуальное индексирование, а не транскрипт.
Как на этот раз считался объём произнесённого контента?
Суммой длины символов по всем речевым чанкам каждой платформы, а не умножением количества на среднюю длительность, как в майском срезе. Это прямой замер проиндексированного текста, поэтому цифра 90,2% измерена, а не оценена.
Можно посмотреть сырые данные?
Нет. Сохранённые видео и поисковые запросы - приватные данные юзеров, они не выгружаются. Каждая цифра в посте - агрегат по обезличенным строкам, и ничто в опубликованной таблице нельзя связать с конкретным человеком или видео.